https://school.programmers.co.kr/learn/courses/30/lessons/161990
프로그래머스
SW개발자를 위한 평가, 교육의 Total Solution을 제공하는 개발자 성장을 위한 베이스캠프
programmers.co.kr
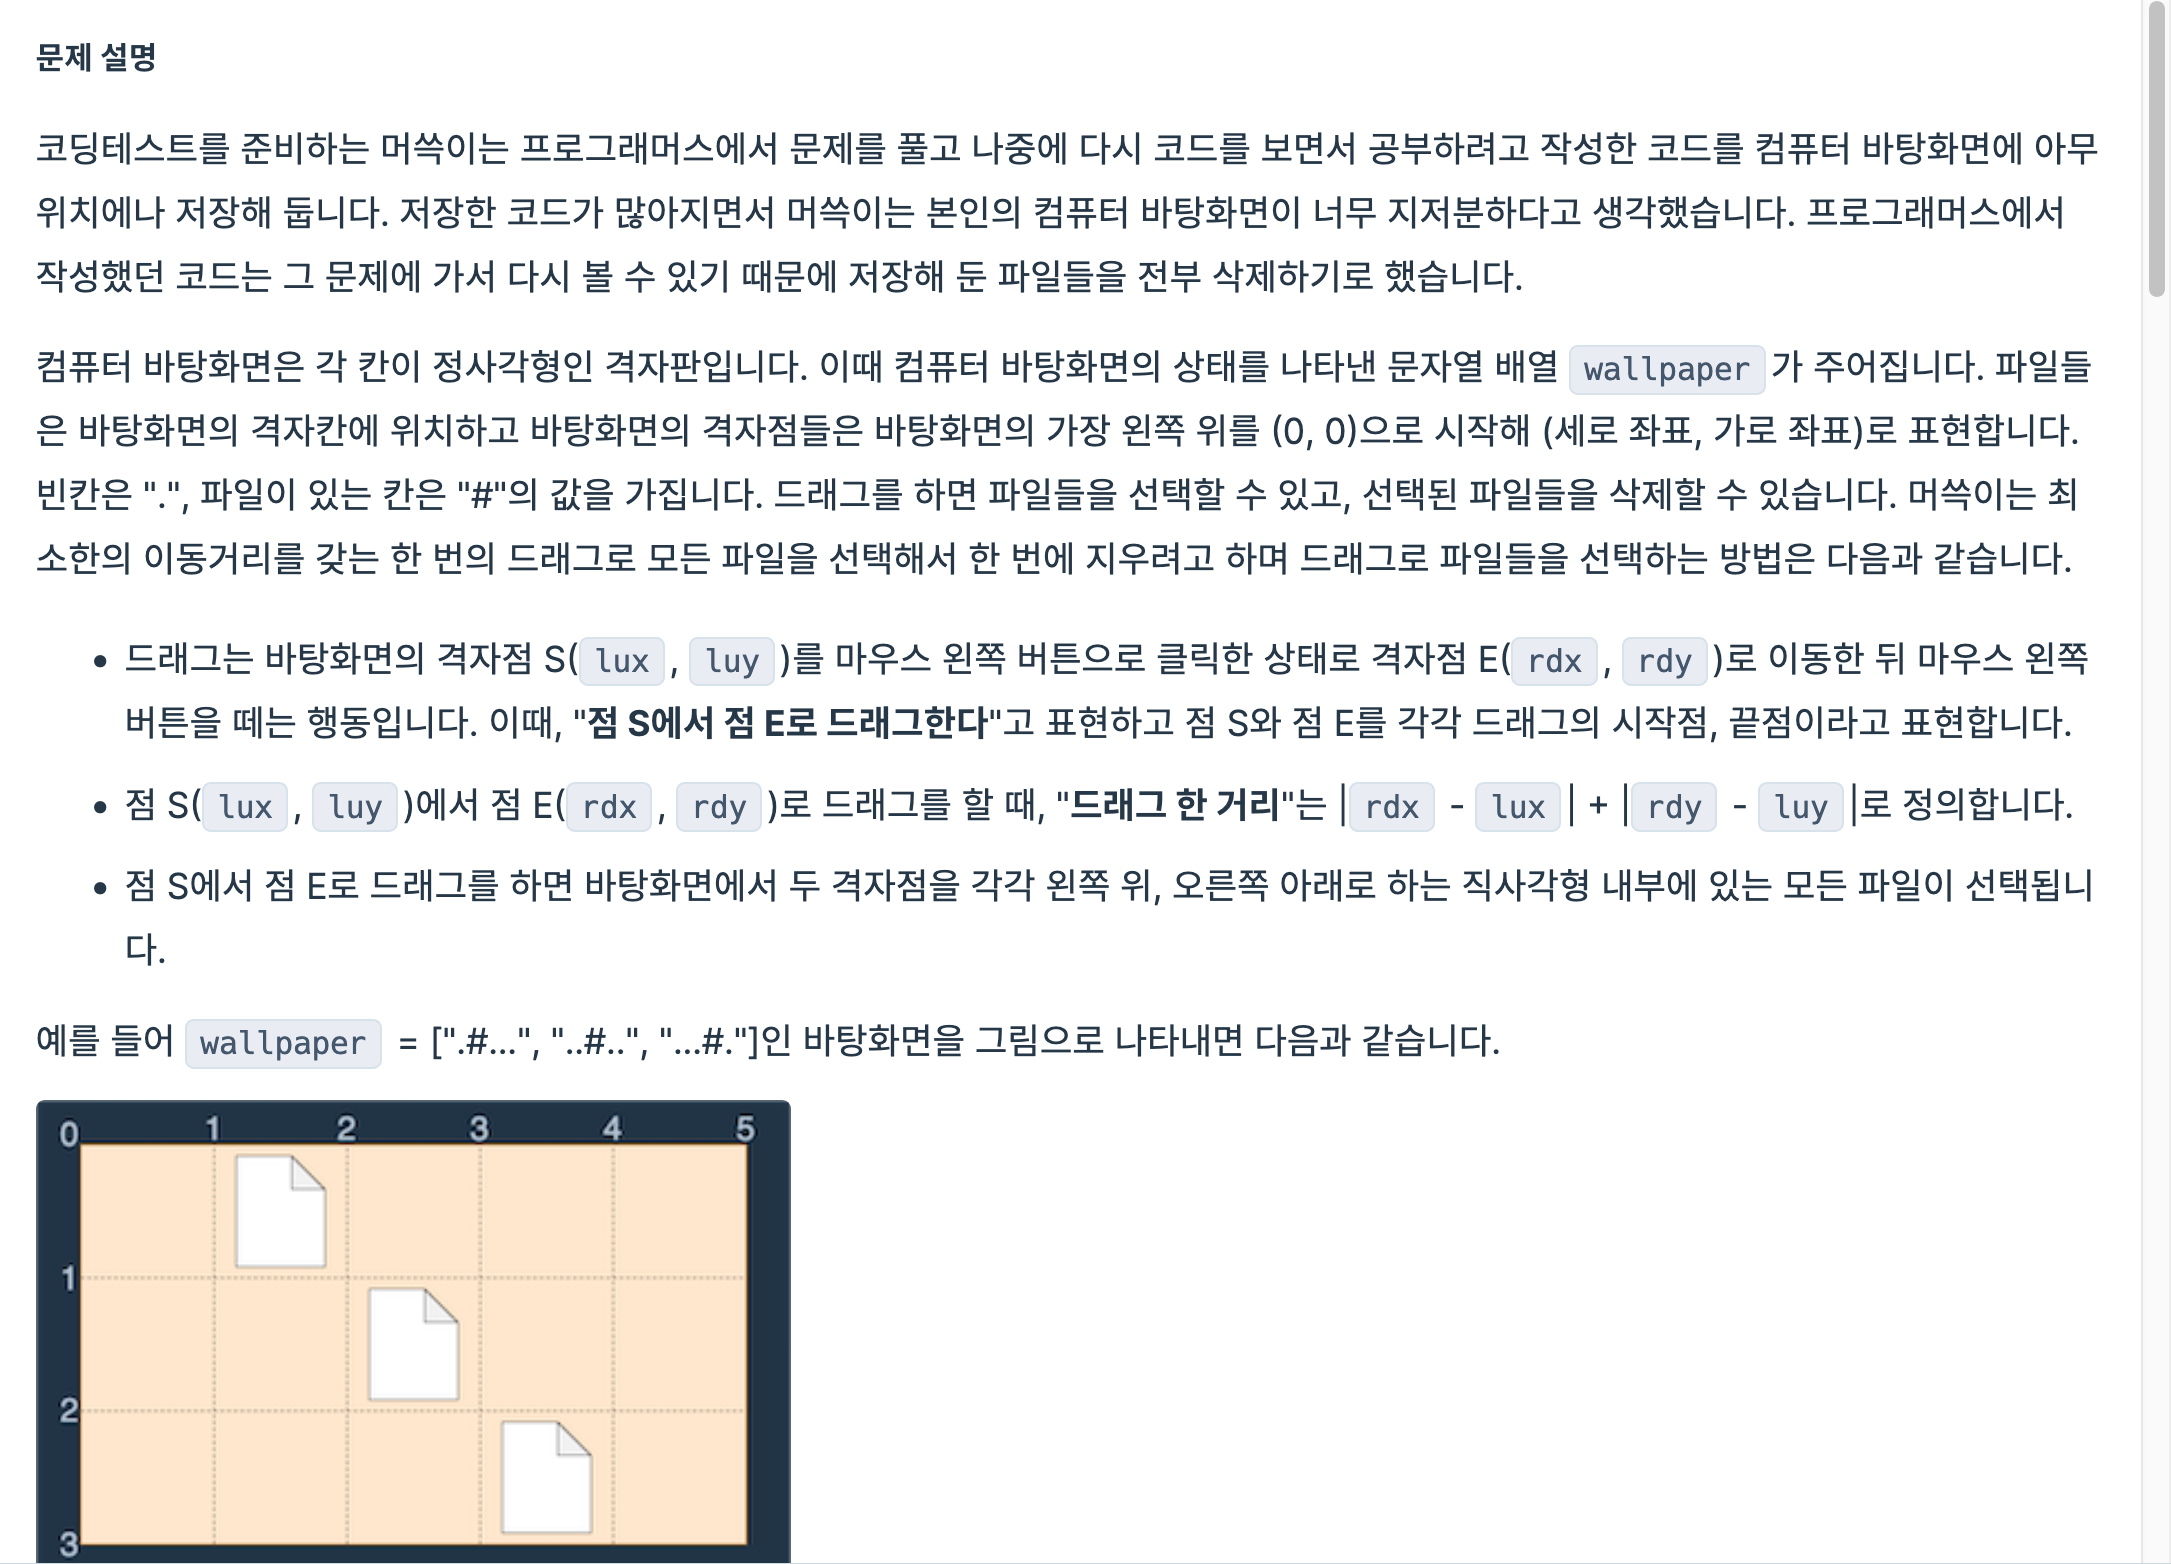
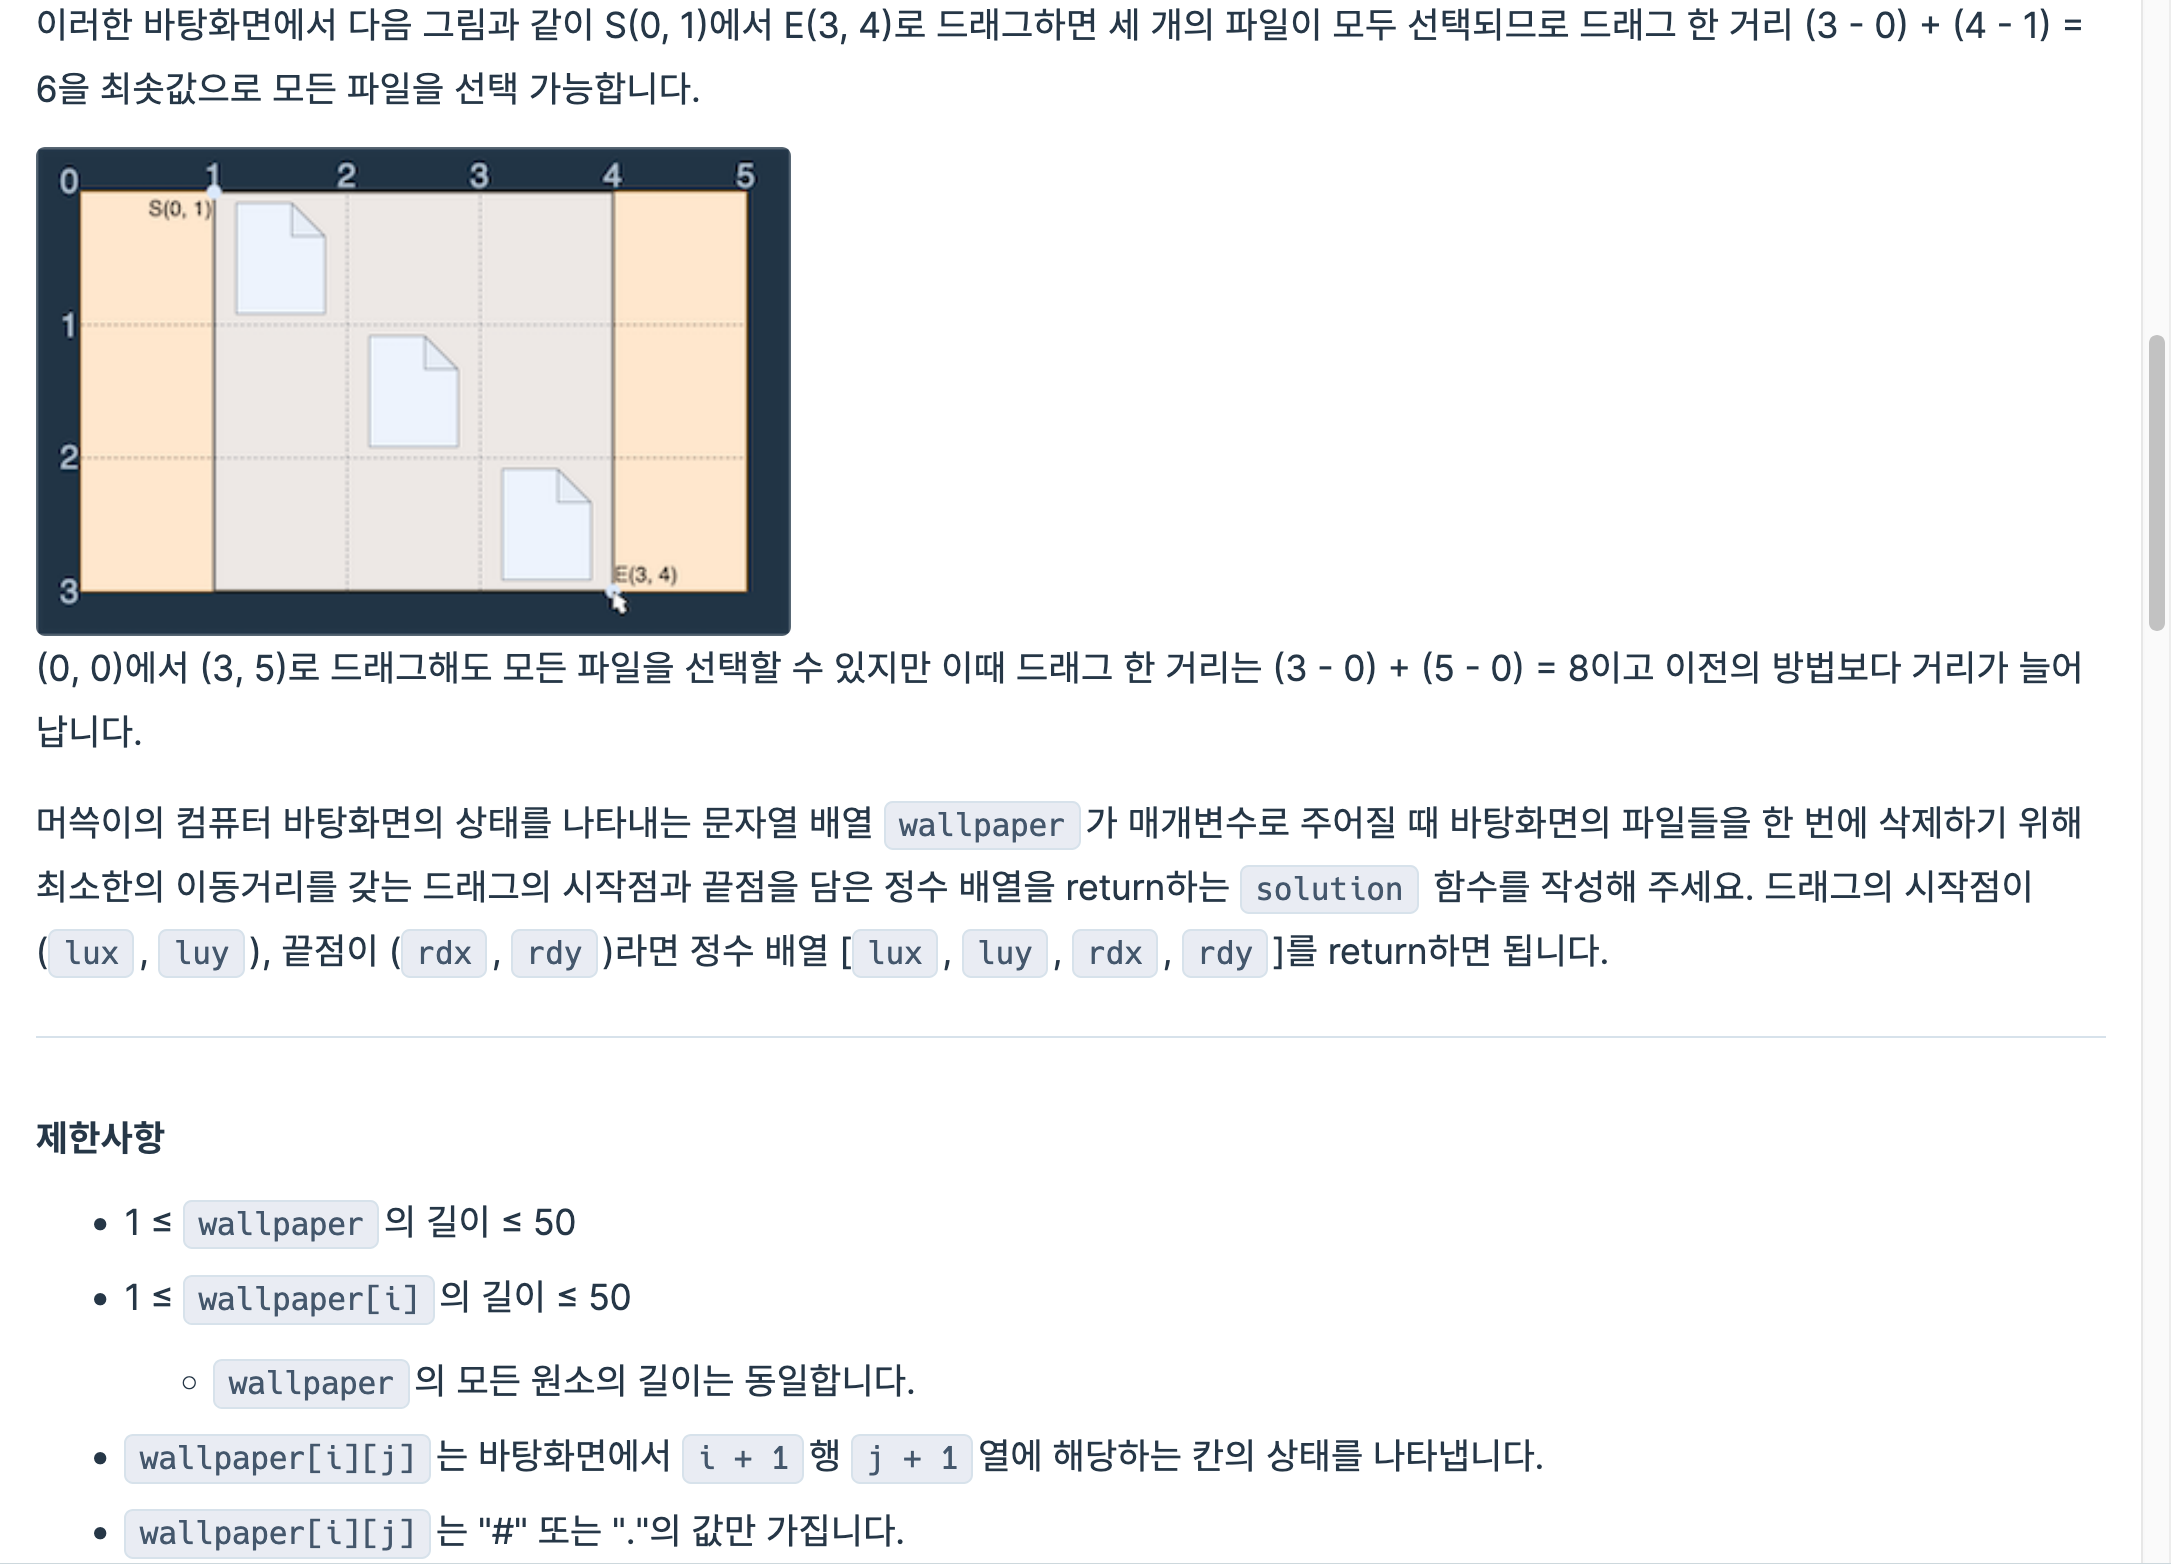
1. 초기 접근 방식 및 문제 인식
처음 문제를 접했을 때의 사고 흐름은 다음과 같았습니다.
- 완전 탐색: 이중 for문을 돌며 바탕화면(2차원 배열)을 탐색한다.
- 좌표 기록: 파일(#)을 발견할 때마다 해당 위치를 기록해 둔다.
- 최소/최대 좌표 도출: 기록된 위치들을 바탕으로 드래그를 시작할 왼쪽 위 꼭짓점과, 드래그를 끝낼 오른쪽 아래 꼭짓점을 구한다.
초기 코드를 작성하며 두 가지 큰 혼란을 겪었습니다.
- x, y 좌표의 늪: 보통 수학에서는 가로가 x, 세로가 y입니다. 하지만 2차원 배열에서는 array[y][x] 순서로 접근해야 하다 보니 코드를 짜는 내내 변수명이 헷갈렸습니다.
- 칸(Space)과 점(Point)의 차이: 파일이 있는 위치를 (2, 3)이라고 할 때, 드래그를 끝내는 지점도 (2, 3)으로 잡으면 파일을 온전히 포함할 수 없었습니다. 파일은 '점'이 아니라 하나의 '칸(면적)'을 차지하기 때문입니다.
💻 초안 제출 코드
def solution(wallpaper):
    lux, luy = len(wallpaper), len(wallpaper[0])
    rdx, rdy = 0, 0
    file = []
    for x in range(len(wallpaper)):
        for y in range(len(wallpaper[x])):
            if wallpaper[x][y] == '#':
                file.append((x, y))

    for locate in file:
        temp_x, temp_y = locate
        lux = min(lux, temp_x)
        rdx = max(rdx, temp_x)
        luy = min(luy, temp_y)
        rdy = max(rdy, temp_y)
    return [lux, luy, rdx+1, rdy+1]
2. 문제 해결의 핵심 인사이트
이러한 고민을 바탕으로 코딩 테스트에 최적화된 두 가지 기준을 세웠습니다.
💡 1. 2차원 배열에서는 x, y 대신 r(row), c(col)을 쓰자
컴퓨터의 2차원 배열은 배열[행(Row)][열(Column)] 순서로 작동합니다. 즉, 첫 번째 인덱스가 '세로(row)'를, 두 번째 인덱스가 '가로(col)'를 움직입니다. 앞으로는 변수명으로 x, y가 아닌 r, c 혹은 i, j를 사용하는 습관을 들이기로 했습니다.
💡 2. '칸'을 감싸기 위한 우하단 좌표는 +1
배열의 인덱스 (r, c)는 그 칸의 '왼쪽 위 꼭짓점'을 의미합니다. 만약 파일이 r=2, c=3 위치에 있다면, 이 파일이 차지하는 공간을 완전히 드래그로 감싸기 위해서는 박스의 우측 하단 끝점이 (3, 4)가 되어야 합니다. 즉, 구한 최대 좌표에 각각 +1을 해줘야만 합니다.
3. Pythonic한 정석 풀이 및 코드 리뷰
초기에는 튜플 (r, c) 형태로 리스트에 저장한 뒤 다시 루프를 돌며 min, max를 구했습니다. 하지만 파이썬의 특성을 십분 활용하여 '가독성'과 '실행 속도'를 극대화한 최종 코드로 리팩토링했습니다.
💻 최종 제출 코드
def solution(wallpaper):
    # 1. 파일('#')이 있는 위치의 행(row)과 열(col) 좌표를 따로 분리하여 담을 리스트
    row, col = [], []

    # 2. enumerate를 활용한 파이썬다운(Pythonic) 2차원 배열 순회
    # i: 행 인덱스 / r: 해당 행의 문자열 전체
    for i, r in enumerate(wallpaper):
        # j: 열 인덱스 / c: 해당 위치의 개별 문자
        for j, c in enumerate(r):

            # 파일('#')을 발견한 경우 좌표 추가
            if c == '#':
                row.append(i)
                col.append(j)

    # 3. 정답 도출 (C언어로 최적화된 min/max 내장 함수 활용)
    # 시작점(좌상단)은 최솟값, 끝점(우하단)은 최댓값에 +1 (칸과 점의 차이 보정)
    return [min(row), min(col), max(row) + 1, max(col) + 1]
🔍 코드 리뷰 및 성능 최적화 포인트
- enumerate의 우아한 활용 단순히 range(len())을 사용하여 wallpaper[i][j]로 접근하는 것보다, enumerate를 사용하면 코드의 가독성이 사람의 언어에 가깝게 향상됩니다. 인덱스와 실제 값을 동시에 뽑아내어 실수를 줄여줍니다.
- 좌표의 분리 저장 (튜플 vs 단일 리스트) 좌표를 (i, j) 튜플 하나로 묶지 않고 row 배열과 col 배열에 분리해서 담았습니다. 덕분에 마지막 리턴 시 복잡한 가공 없이 직관적으로 min(row)와 max(row)를 호출할 수 있게 되었습니다.
- C언어 엔진을 활용한 연산 위임 (왜 빠른가?) 탐색하면서 매번 if문이나 min(), max()로 변수를 갱신하는 '1-Pass 탐색' 방식도 메모리 측면에서 좋지만, 파이썬에서는 위 코드처럼 리스트에 값만 빠르게 append 한 뒤, 마지막에 내장 함수 min(), max()를 한 번만 호출하는 것이 실행 속도 면에서 압도적으로 유리한 경우가 많습니다. 파이썬의 내장 함수는 C언어로 고도로 최적화되어 있기 때문입니다.
4. 마무리
단순히 답을 맞히는 것을 넘어, 2차원 배열의 좌표계를 명확히 이해하고 파이썬이라는 언어가 가진 내장 함수의 이점을 어떻게 활용할 것인가 고민해 볼 수 있는 좋은 문제였습니다. 앞으로의 2차원 탐색 문제에서도 r, c 네이밍 룰과 enumerate를 적극 활용하려고 합니다.
'알고리즘 > 프로그래머스(lv1)' 카테고리의 다른 글
| [프로그래머스/Lv1/파이썬] 크레인 인형뽑기 게임 (0) | 2026.10.28 |
|---|---|
| [프로그래머스/파이썬] K번째수 _ 풀이 (0) | 2025.11.22 |